Разработчик встроил в Qwen виртуальный GPU для исполнения CUDA
Новость опубликована 02.11.2026 ⦁ источник
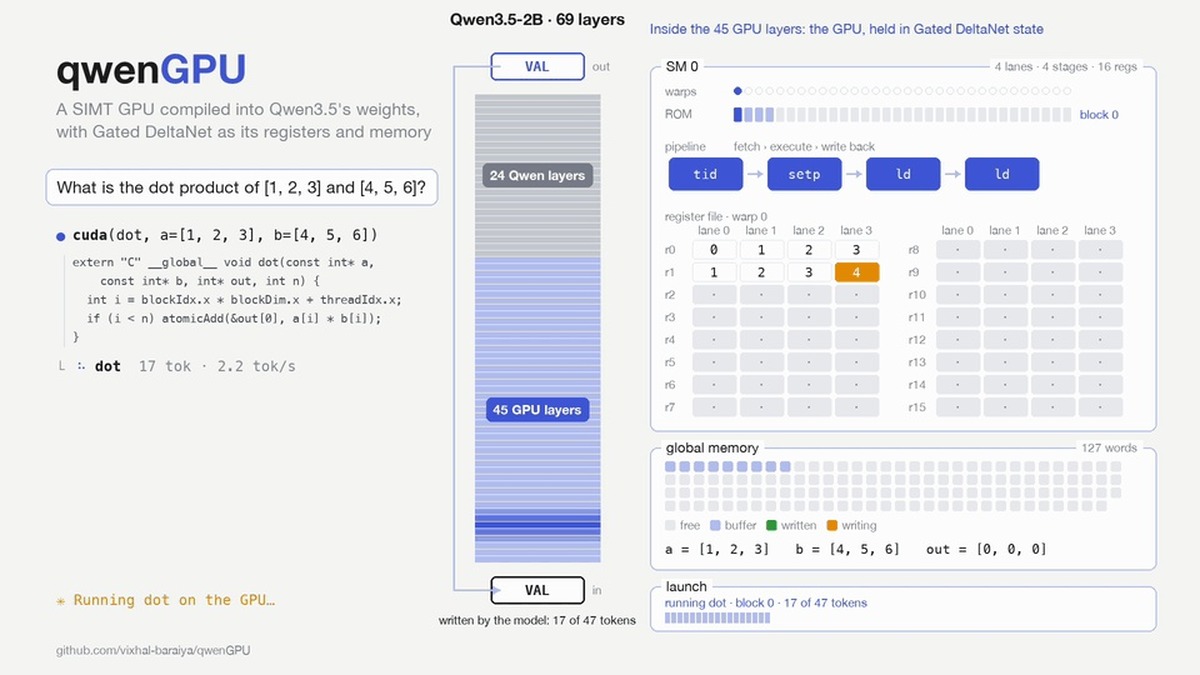
Vixhal / qwenGPU — кадр авторской демонстрации
Разработчик Vixhal опубликовал qwenGPU — экспериментальную версию Qwen3.5-2B, внутри которой исполняются небольшие CUDA-программы. Перед 24 слоями исходной языковой модели он добавил ещё 45: их веса рассчитаны компилятором, а не получены обучением. Эти слои образуют виртуальный GPU с регистрами и памятью. Код проекта и демонстрация появились 1 ноября.
Обычная генерация ответа не гарантирует правильной арифметики. Здесь вычисление задано программой: внешняя часть системы переводит CUDA-код в инструкции и загружает входные числа, а добавленные слои выполняют команды, ветвления и запись результатов. Каждый проход нейросети продвигает исполнение программы; итог считывается из её внутреннего состояния. Проект использует компилятор Qwenputer, ранее встраивавший в Qwen процессор RISC-V, и расширяет этот подход до GPU-подобной машины.
Точное исполнение, однако, не гарантирует правильного выбора вычисления. По отчёту автора, в обычном режиме чат ответил на 20 из 24 проверочных вопросов числами, полученными через встроенный GPU. В расширенном режиме, где Qwen сама пишет CUDA-код, правильная программа получилась с первой попытки в четырёх из пяти задач. Отдельный результат 49 из 49 относится к сверке эталонного интерпретатора с настоящей NVIDIA Tesla T4; запуски самой нейросети автор сверял с этим интерпретатором. Это разные проверки, а независимое воспроизведение результатов пока не представлено.
Масштаб машины пока крошечный: четыре вычислительные линии и общая память на 126 чисел. Поддерживаются 32-битные целые числа; вычислений с плавающей точкой нет. Один запуск занимает десятки или сотни генерируемых токенов, а на использованной автором платформе Apple Silicon скорость составляла около 10–15 токенов в секунду. Оснований считать такую конструкцию заменой видеокарте или способом ускорить ИИ эти результаты не дают.
Для самостоятельной сборки опубликован код под лицензией MIT; команда сборки скачивает Qwen3.5-2B и добавляет вычислительные слои, для работы заявлено около 16 ГБ свободной памяти. Ценность эксперимента — в конкретном способе совместить языковую модель с точным исполнением команд внутри одной нейросети. При этом ответственность за верную постановку задачи и правильную программу никуда не исчезает.
AI qwenGPU, Qwen3.5-2B, CUDA, Qwenputer

