Microsoft открыла инструмент для запуска нейросетей робота на внешнем GPU
Новость опубликована 23.09.2026 ⦁ источник
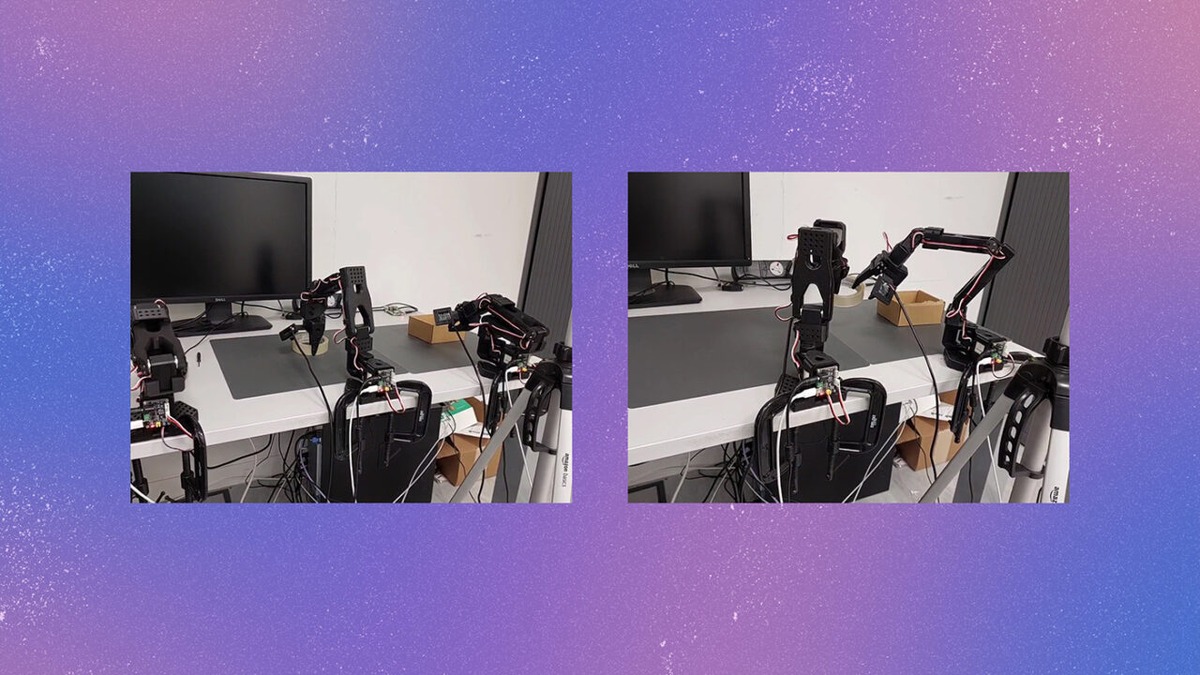
Microsoft Research добавила в открытый Physical AI Toolchain механизм offloaded inference. Он переносит вычисления нейросетевой модели с робота на внешний GPU: система упаковывает сервис в контейнер, разворачивает его через Kubernetes и связывает с машиной по сети. Компания опубликовала примеры для манипуляторов SO-101 и UR10e, а также показала модель Rho, управляющую Mobile Aloha через удалённый NVIDIA Jetson Thor.
Такой перенос нужен не только ради более мощной модели. В предыдущем исследовании команды Microsoft, Университета Карнеги — Меллона и Вашингтонского университета небольшие бортовые ускорители не всегда справлялись со всем стеком восприятия, планирования и управления. В отдельных тестах картографирование и планирование на роботе занимали до 4,83 раза больше времени, чем на A100, а своевременное обнаружение препятствий на слабом GPU снижалось на 30%. Для Stretch 3 замена бортового GPU на Raspberry Pi 5 с удалённым ускорителем более чем удвоила расчётное время работы от батареи.
Новый результат — не эти мартовские измерения, а доступный код инструмента и готовые схемы его подключения к нескольким роботам. Это даёт разработчикам способ выбирать между массой и энергопотреблением бортового компьютера, мощностью внешнего GPU и задержкой сети, не переписывая всю систему под каждый вариант.
При этом перенос вычислений не является универсальным ускорителем. Та же работа Microsoft показала, что задержка может ухудшать точность управления, а пропускная способность делает наивное подключение через публичное облако непрактичным. Опубликованные примеры ориентированы прежде всего на локальный внешний GPU; независимых данных о производственных внедрениях новой функции пока нет.
AI Microsoft, Physical AI Toolchain, Rho, Mobile Aloha, offloaded inference, robotics