METR всё труднее находить людей, обгоняющих ИИ в тестах кода и оптимизации
Новость опубликована 22.11.2026 ⦁ источник
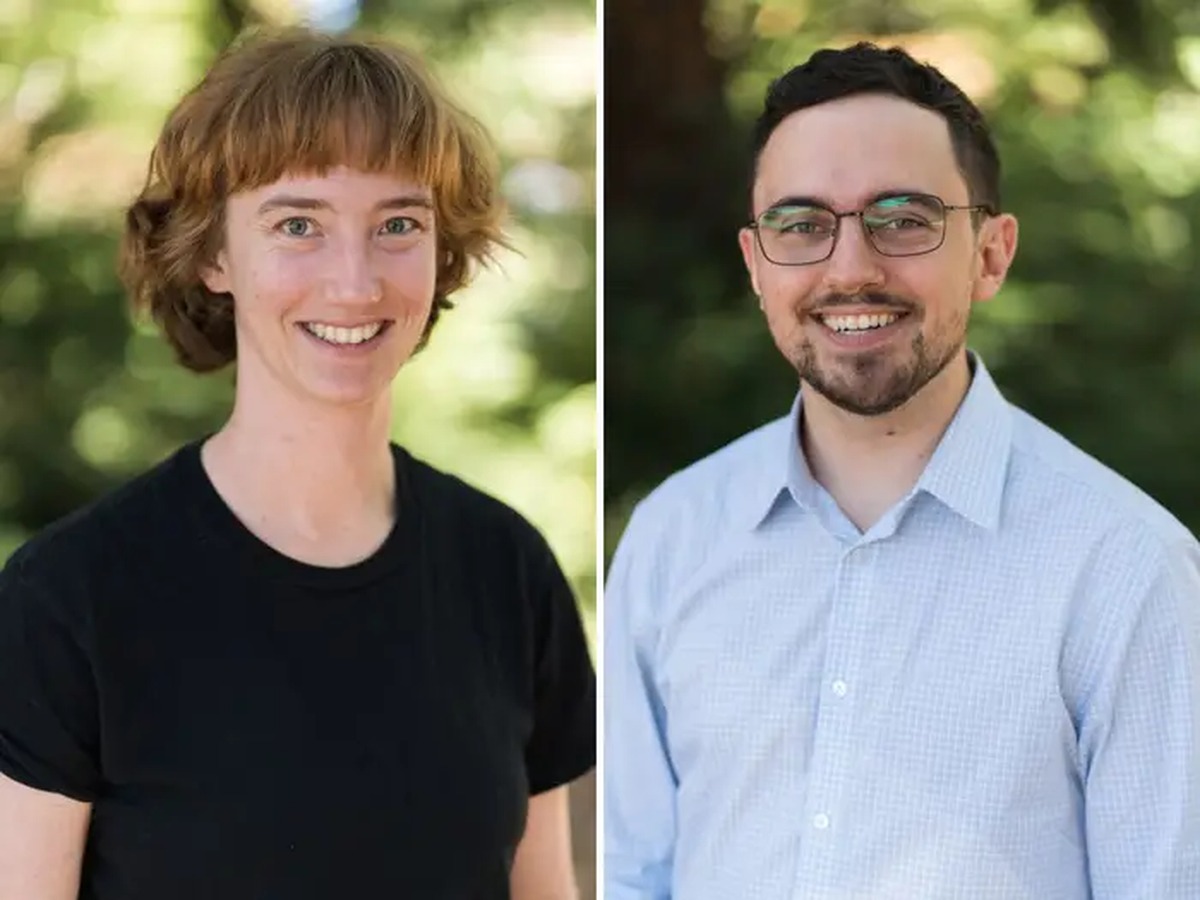
Бет Барнс и Крис Пейнтер, руководители METR. Архивное изображение Business Insider.
Организации METR всё труднее находить специалистов, которые превосходят модели в её задачах программирования и оптимизации. В отчёте от 20 ноября исследователи представили 36 новых задач: прежний набор за год оказался слишком лёгким для сильнейших моделей. Теперь проверяют и работу, где качество нельзя измерить автоматическим тестом.
В 15 конкурсах оптимизации лучшие модели показали медианный результат на уровне 96–98-го процентиля участников — выше подавляющего большинства, но ниже лидеров. Агентам дали 48 часов, людям на конкурсы отводилось около трёх месяцев. Это сравнение результатов при разных условиях, а не одинакового рабочего времени.
Без ясной обратной связи картина хуже. Ни одно созданное агентами задание METR не сочла достаточно полезным для включения в отчёт. Модели-судьи завышали качество заданий, сделанных сопоставимыми или более сильными моделями. Авторы допускают, что настройка испытаний не раскрыла всех возможностей: агенты недоиспользовали доступные ресурсы.
Есть ограничение и у оценки длительности человеческой работы: лишь три из 34 задач с временными ориентирами опираются на успешные человеческие прогоны, остальные — на оценки исследователей. Общий индекс способностей публичных моделей не показал убедительного ускорения или замедления. Рост результатов продолжается, но эти испытания ещё не устанавливают, насколько ИИ ускоряет исследования и разработку моделей.
AI METR, Оценка возможностей ИИ, Автоматизация исследований