Два текста совместили в одном проходе языковой модели — точность достигла 43%
Новость опубликована 24.09.2026 ⦁ источник
Исследователи смешали в одном входе векторные представления двух независимых текстов и дообучили языковую модель разбирать получившийся поток обратно на два продолжения. В препринте от 24 сентября лучший вариант на тесте LAMBADA получил среднюю точность 43,0% для двух потоков против 18,2% у той же Llama 3.2 3B без специального обучения. Но обычный отдельный запуск большой модели давал 64,3%, а вспомогательной модели на 1 млрд параметров — 54,0%.
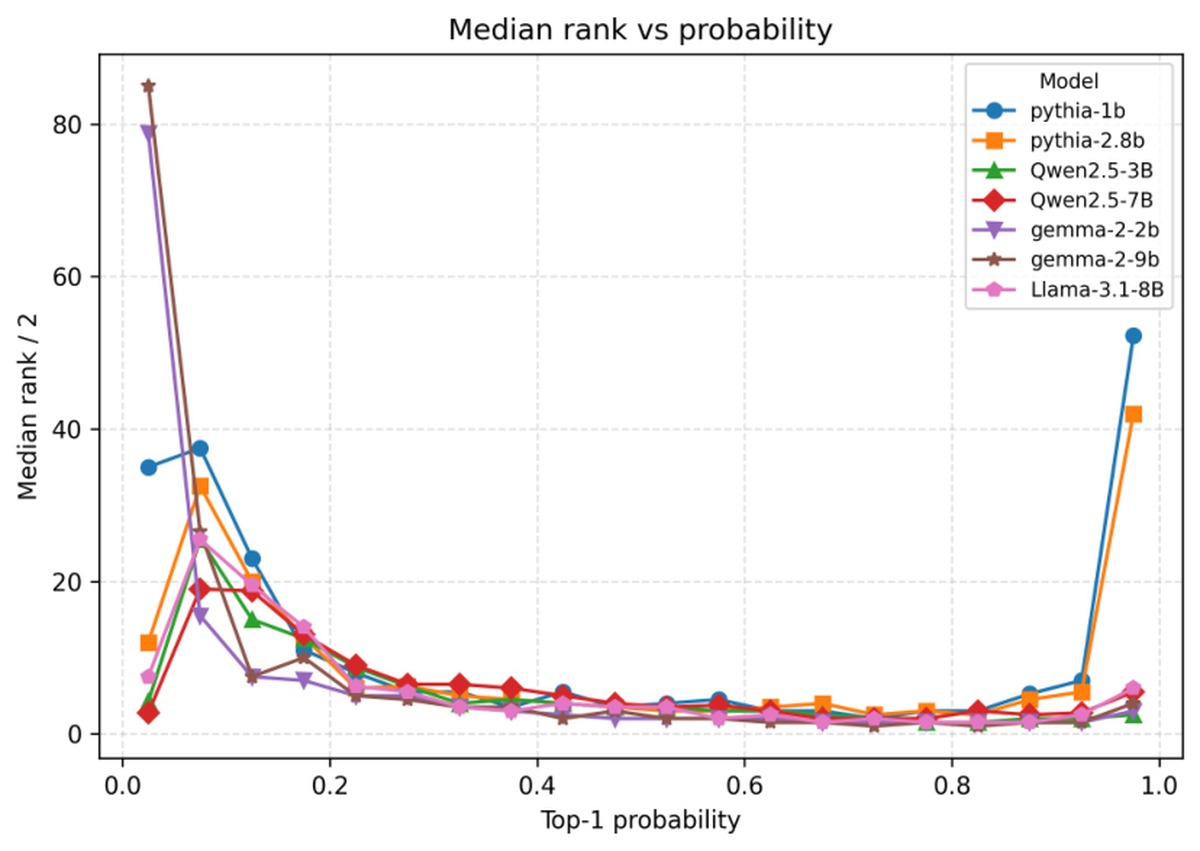
Обычно каждый независимый текст требует собственного прохода модели или отдельного элемента пакета. Авторы вместо этого усреднили векторные представления токенов двух текстов. Даже без дообучения ожидаемый следующий токен каждого исходного текста оставался среди десяти лучших вариантов в 30–40% случаев. После специального дообучения для сложных смысловых токенов его медианное место поднялось с 284-го до 5-го, а точное совпадение достигло 22,8%.
Лучший способ разделения потоков всё же использовал не только один смешанный проход большой модели: маленькая модель отдельно читала каждый исходный контекст и подсказывала, как развести ответы. На Llama эта схема генерировала 52,4 токена в секунду против 41,3 при двух последовательных запусках, но обычная пакетная обработка двух текстов давала 81,4 токена. Упрощённый вариант без модели-подсказчика сравнялся с пакетом по скорости, однако его точность на LAMBADA составила лишь 10,5%.
Это предварительный результат авторов без независимого воспроизведения. Он показывает, что трансформер способен сохранить два смысловых потока в одном скрытом состоянии, но не доказывает готового двукратного ускорения: самый точный вариант уступает обычному раздельному запуску и по качеству, и по скорости пакетной обработки.
Линейная суперпозиция, Llama 3.2, Qwen 2.5, Pythia, LAMBADA, Трансформер