Thinking Machines выпустила Inkling 2 Mini для локального запуска на Mac
Новость опубликована 21.11.2026 ⦁ источник
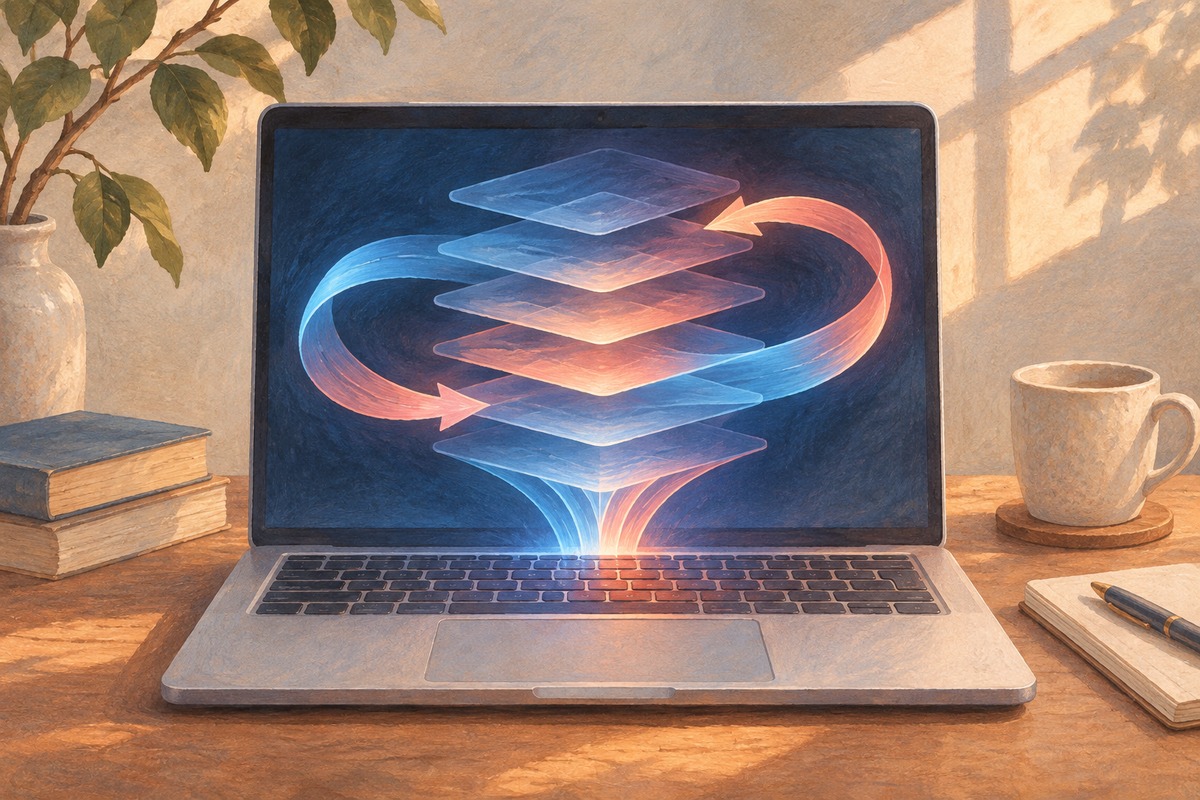
Изображение создано ИИ
Thinking Machines Lab 20 ноября выпустила Inkling 2 Mini с открытыми весами. По требованиям разработчика, модель можно запускать на устройствах Apple silicon с памятью от 32 ГБ. После серверной Inkling 2 Small, которой требовалось минимум 500 ГБ видеопамяти, это отдельная, гораздо меньшая модель для работы на собственном компьютере.
Веса Mini опубликованы на Hugging Face под Apache 2.0; модель принимает текст и изображения и отвечает текстом. В карточке модели указаны пакет около 20 ГБ, поддержка DGX Spark и рекомендация от 32 ГБ видеопамяти для других GPU. Объём весов не равен полной потребности в памяти при любом размере контекста. Для Apple предлагаются Ollama и Exo Labs; доступ через облачный Tinker также открыт.
Особенность Mini — повторное использование слоёв нейросети. Из 24 слоёв средние 12 выполняются трижды для каждого генерируемого токена: получается 48 последовательных применений слоёв, но хранить три отдельные копии их весов не нужно. У модели 26,4 млрд параметров. Такой подход добавляет вычисления без соответствующего увеличения набора весов; авторы связывают с ним улучшение рассуждений при небольшом размере модели.
В опубликованной разработчиком таблице Mini решила 48,2% задач DeepSWE v1.1 против 42,2% у Qwen3.8-27B; для этой строки указана оболочка mini-swe-agent v2.4.6. На Terminal Bench v2.1 результат обратный: 71,6% против 73,0%. Условия оценивания моделей различаются, а скорость на сравнительном графике — теоретический потолок при заданной пропускной способности памяти, не замер работы на ноутбуке. Универсального превосходства эти цифры не устанавливают.
Для проверки самого метода компания также выпустила исследовательский вариант с меняющимся числом проходов. В её экспериментах дополнительные проходы улучшали работу с длинным контекстом, но не результаты тестов на фактические знания. Теперь исследователи могут проверять этот способ увеличения вычислений на открытой модели. Локальный запуск редакция самостоятельно не испытывала.
AI Thinking Machines Lab, Inkling 2 Mini, Открытые веса