ElevenLabs добавила разметку говорящих в потоковую расшифровку Scribe
Новость опубликована 11.11.2026 ⦁ источник
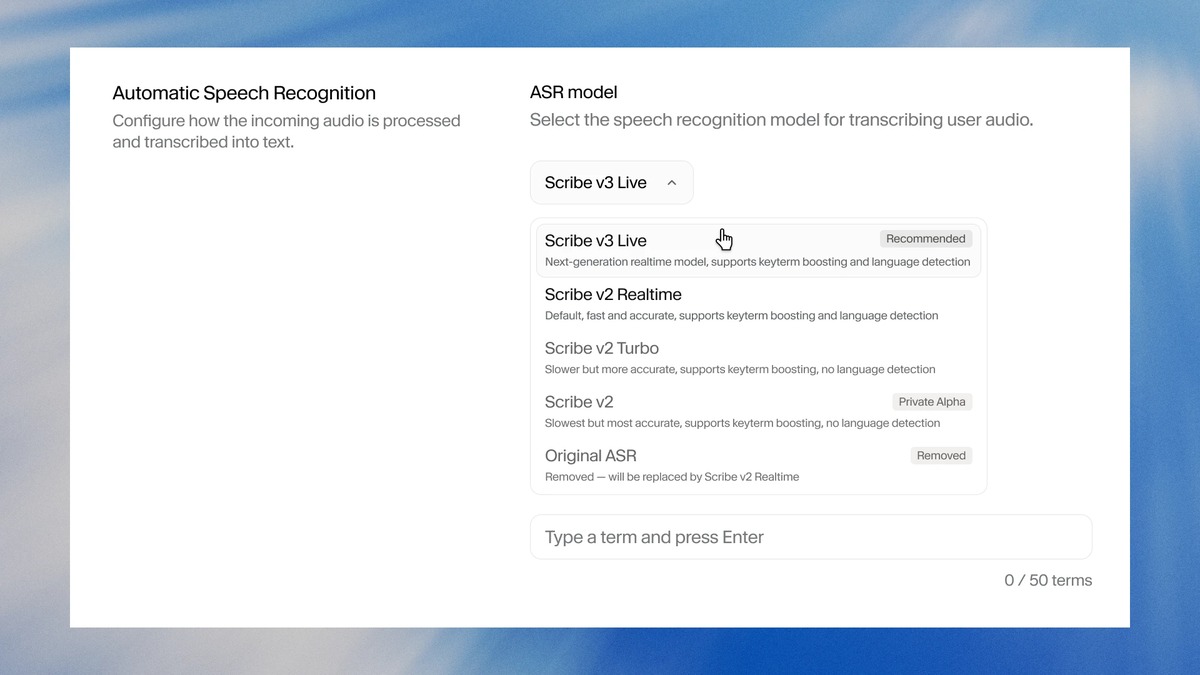
ElevenLabs — скриншот интерфейса
ElevenLabs 10 ноября выпустила Scribe v3 и Scribe v3 Live — модели расшифровки записей и речи в прямом эфире. Потоковая версия впервые в этой линейке получила разметку говорящих: в тексте можно различать реплики участников, а не получать один общий поток слов. Обе модели доступны через API; Live также предложена в ElevenAgents.
По испытаниям ElevenLabs, обычная Scribe v3 делает на 27% меньше ошибок в словах, чем v2. Документация уточняет: средняя ошибка снизилась с 16,94% до 12,38% на FLEURS, где проверяли короткие записи прочитанной речи на 102 языках. Компания усредняла ошибки сначала по фрагментам, затем по языкам — напрямую сравнивать эти числа с рейтингами, рассчитанными иначе, нельзя.
Для Live разработчик сообщает о снижении обычной ошибки распознавания слов на 31% относительно v2 Realtime. Разметку говорящих проверяли отдельно: на английской части собственного набора разговоров ошибка составила 3,1%. Перед подсчётом тексты выровняли с эталоном, исключая влияние ошибок распознавания; это не доля всех ошибок стенограммы и не показатель, сопоставимый с тестом разметки готовых записей.
Практическое изменение касается приложений, которым нужен текст разговора уже во время общения. В API также перенесли определение конца реплики по контексту, ранее работавшее в ElevenAgents: одна пауза не должна автоматически означать, что человек закончил говорить. Заявленные улучшения пока подтверждены испытаниями производителя; собственный набор разговоров на 16 языках он обещает открыть позднее.
AI ElevenLabs, Scribe v3 Live, Распознавание речи

