В Faiss появился e-means — более быстрый способ группировать большие массивы данных
Новость опубликована 11.11.2026 ⦁ источник
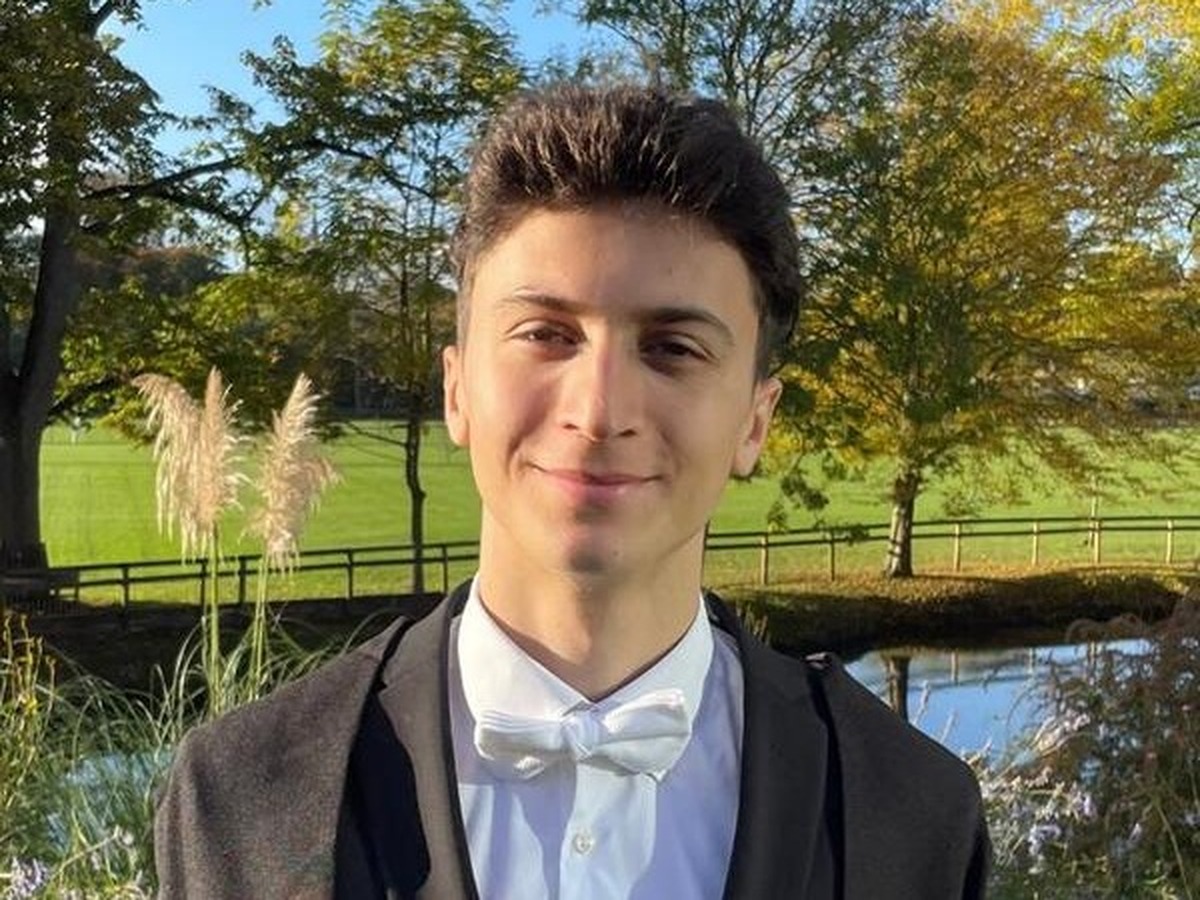
Сванн Бесса, соавтор e-means — фотография с личного сайта; кадрирование
В выпущенную 10 ноября Faiss 1.16.0 включили e-means — метод кластеризации от FAIR Meta и французской École des Ponts. Он группирует похожие векторы: числовые представления изображений, текстов и других данных. Такая операция нужна при подготовке обучающих наборов, сжатии и построении поисковых индексов. Новое сейчас — доступная реализация в библиотеке; препринт с результатами авторы выложили 6 ноября.
Обычный алгоритм k-means Ллойда многократно проходит весь массив и пересчитывает центры групп. Более быстрые варианты с небольшими порциями данных часто проигрывают ему по точности. e-means обновляет центры по таким порциям, используя экспоненциальное скользящее среднее и постепенно уменьшая величину изменений. Параметры подбираются по формулам, полученным авторами в предварительных экспериментах: отдельно перебирать их для каждого набора не требуется.
В тестах исследователей e-means достигал ошибки Flash-KMeans после 25 проходов за 1,4–2,6 прохода. На ускорителях H100 это соответствовало выигрышу во времени от 9,5 до 45,5 раза в зависимости от набора и масштаба. Сравнивали расстояния от векторов до центров групп на отложенных данных. До 100 млн векторов приводили медиану результатов десяти запусков; для миллиарда использовали один запуск и восемь GPU. Это измеренное ускорение кластеризации, а не всей работы нейросети.
Код можно использовать на CPU и GPU; для последнего нужны дополнительные вычислительные библиотеки. Авторы предупреждают, что их правила выбора параметров не оптимальны для очень маленьких наборов и данных с малым числом измерений. В выпущенной реализации для таких случаев уже предусмотрены отдельные настройки. Практический результат — открытый способ сократить одну из дорогих операций подготовки больших массивов данных; конкретный выигрыш остаётся зависимым от самих данных и оборудования.
AI e-means, Faiss, Meta, Кластеризация, Большие данные

