Открыли Apollo — модель восстанавливает древнегреческие тексты без известной длины пропуска
Новость опубликована 23.09.2026 ⦁ источник
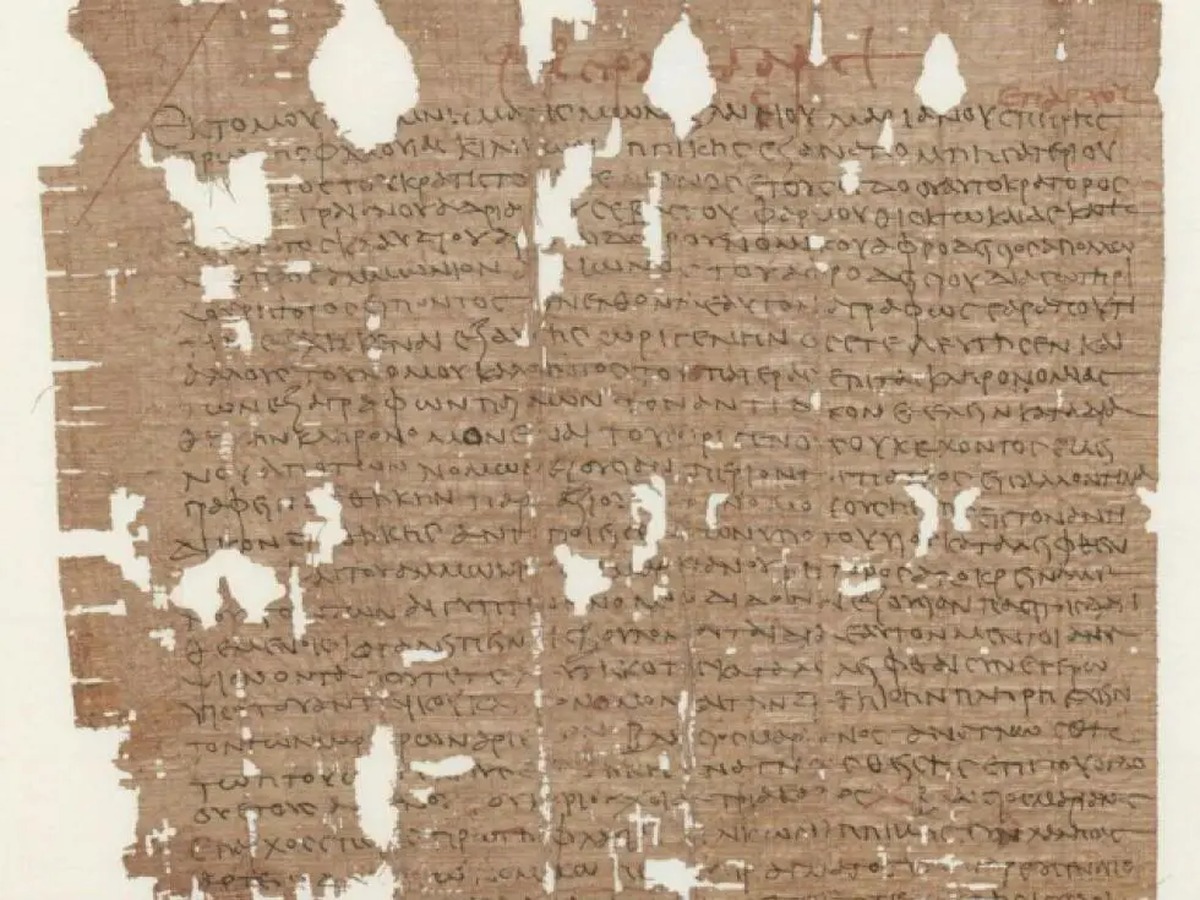
Австрийская академия наук 23 сентября открыла бесплатный доступ к Apollo — 24-миллиардной языковой модели для восстановления утраченных фрагментов древнегреческих папирусов и надписей. Текст до и после повреждённого места вводят в веб-приложение, а система предлагает варианты заполнения. Её разработали вместе с Mistral AI и SAIL Reply на основе Mistral Small, дообучив примерно на 600 млн слов.
Главное отличие от прежних систем — Apollo не нужно заранее сообщать точное число утраченных знаков. Ithaca и модель Cullhed зависели от такой подсказки, хотя по разрыву папируса длину пропуска часто определить невозможно. В препринте авторы сообщают: на сбалансированной проверке документальных папирусов лучший вариант Apollo совпал с известным текстом в 43,2% случаев при точной подсказке и в 33,2% без неё; Cullhed даже с точной длиной получил 15,5%.
В слепой проверке 20 папирологов, эпиграфистов и филологов варианты Apollo для документальных папирусов выбирали лучшими в 59,0% сравнений с Cullhed, варианты Cullhed — в 13,8%, ещё 27,2% закончились ничьей. Авторы также подсчитали, что с учётом совпадений с опубликованными реконструкциями предложение Apollo было не хуже человеческого примерно в 77% лакун документальных папирусов. Это не значит, что модель понимает историю на уровне специалиста: эксперты оценивали правдоподобие вариантов, а окончательное чтение по-прежнему выбирает человек.
Ограничения у результата существенные. Работа пока остаётся препринтом; независимого воспроизведения нет, а в части литературных папирусов участвовал лишь один эксперт. Последовательное заполнение нескольких пропусков может накапливать ошибки, необычные диалекты и орфография остаются трудными. Веб-приложение уже доступно, но веса, данные и код оценки авторы пока только обещают опубликовать. Поэтому состоявшийся результат — открытый инструмент и измеренное превосходство над прежними системами в заданных тестах, а не универсальная расшифровка античных рукописей.
Apollo Restore, Австрийская академия наук, Mistral AI, SAIL Reply, Древнегреческий язык, Папирология