ИИ-агент достиг 95% успеха против 47% у ручных планировщиков в симуляциях
Новость опубликована 24.09.2026 ⦁ источник
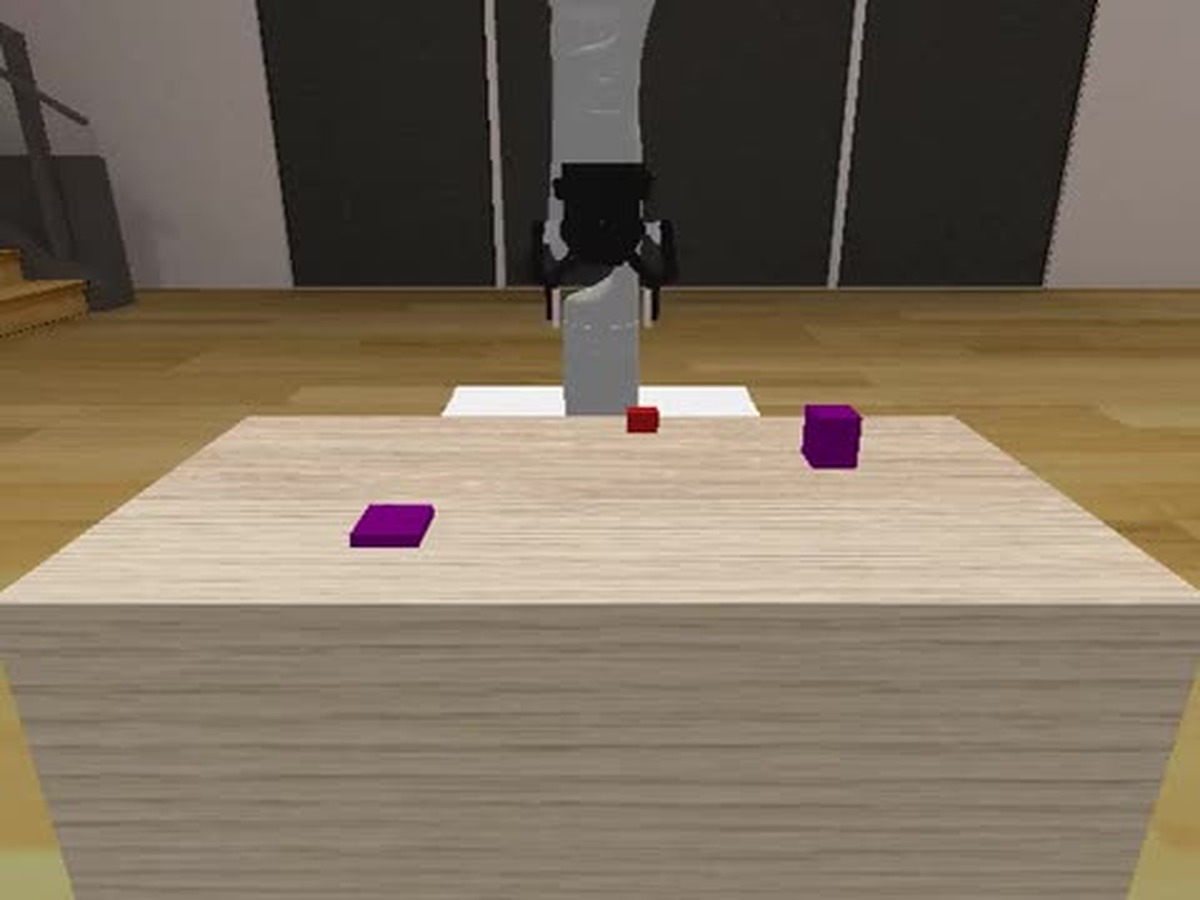
В препринте исследователи дали Claude Code Opus 5 и Codex с моделями GPT-5.6 Sol и GPT-6 Astra описание робототехнических задач и доступ к симулятору, а затем предложили написать многоразовые программы-планировщики. На 16 средах, где был доступен написанный людьми планировщик, программа от Astra показала в среднем 95% успешных выполнений против 47% у ручного решения; Opus достигла 82%, Sol — 56%.
Во время проверки языковая модель уже не участвовала: каждому агенту давали до $20 на исследование среды, тесты и написание кода, после чего программу замораживали. Авторы сгенерировали 980 программ и проверили каждую на 100 новых экземплярах задач — всего 98 тысяч эпизодов. В отличие от подходов, которые снова вызывают модель для каждого задания, готовые программы в среднем тратили примерно на порядок меньше вычислений на один экземпляр.
Результат оказался неоднородным. Astra сохраняла 65% успеха на самой сложной группе динамических трёхмерных сред, но в отдельных задачах с подметанием и переливанием лучшие показатели оставались низкими: 3% для SweepSimple, 14% для ScoopPour и 29% для ConstrainedCupboard. Доступ к исходному коду среды иногда резко улучшал результат, то есть агенты выигрывали не только за счёт общего понимания физики, но и за счёт доступных им деталей реализации.
Эксперимент проводился только в симуляциях с полностью наблюдаемым состоянием объектов и доступом к симулятору на этапе разработки. Он не проверяет восприятие реального мира и работу на физическом роботе; кроме того, авторы не могут исключить попадание кода бенчмарков в обучающие данные моделей. Пока это сильный результат для кодовых агентов как планировщиков в заданной среде, а не доказательство автономности роботов в реальности; независимого воспроизведения препринта ещё нет.
AI GPT-6 Astra, Claude Code, Codex, AgenticGenPlan, Планирование задач и движений, Принстонский университет