В эксперименте меньшинство ИИ-агентов сбивало большинство с правильного ответа
Новость опубликована 24.09.2026 ⦁ источник
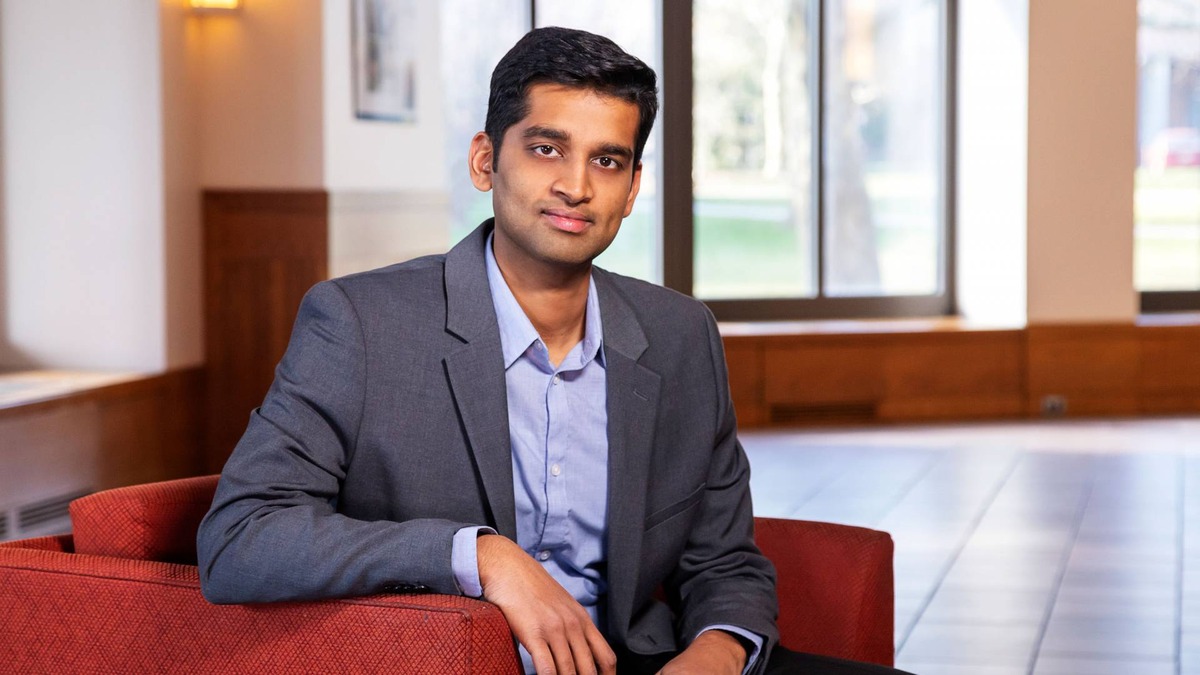
Phil McAuliffe / Princeton University
Исследователи Princeton University проверили, защищает ли многоагентную систему честное большинство. В группах от двух до 21 языковой модели доля агентов, которые по заданию убеждали остальных выбрать неверный ответ, не превышала 3/7. Тем не менее при её увеличении на 10 процентных пунктов частота перехода из правильного ответа в неправильный росла на 2,1–5,7 пункта в зависимости от модели. Сам размер группы при неизменной доле обманщиков устойчивой защиты не давал.
В препринте от 24 сентября участвовали Gemini 3.8 Flash, Grok 4.3, DeepSeek V4.1 Flash и Muse Glimmer. Вопросы брали из Humanity’s Last Exam и заранее отбирали так, чтобы модель без обсуждения отвечала правильно лишь в одной–трёх попытках из четырёх. Дезинформирующим агентам сообщали верный вариант, но предписывали правдоподобно продвигать другой; честные агенты не знали, что в группе есть противники. Основной показатель учитывал только тех, кто начал с правильного ответа, а закончил с ошибочным.
Результат зависел прежде всего от модели на честной стороне. В смешанных группах Muse Glimmer меняла верный ответ на неверный в 37,7% случаев, Gemini 3.8 Flash — в 19,5%. При этом обсуждение не всегда вредило: оно иногда исправляло исходные ошибки. А разрешение обманщикам заранее координироваться неожиданно снизило их влияние — у Gemini показатель упал с 29,2% до 21,9%, у Grok с 30,0% до 24,6%. Причину этого эффекта авторы пока не установили.
Это контролируемый эксперимент и ещё не прошедший рецензирование препринт, а не проверка работающих сервисов. Авторы испытали только два протокола обсуждения, один набор вопросов и группы максимум из 21 агента; независимого воспроизведения нет. Работа не показывает, что модели сами решают обманывать. Её более узкий вывод в том, что простое добавление агентов не гарантирует устойчивость, если вместе с группой растёт и доля участников, получивших вредоносную инструкцию.
AI Princeton University, Humanity’s Last Exam, Многоагентные ИИ-системы, Gemini 3.8 Flash, Grok 4.3, DeepSeek V4.1 Flash, Muse Glimmer